Domain revenue-share.de kaufen?
Wir ziehen mit dem Projekt
revenue-share.de um.
Sind Sie am Kauf der Domain
revenue-share.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain revenue-share.de kaufen?
Wie funktioniert die Textklassifizierung und welche Methoden werden dabei häufig angewendet?
Die Textklassifizierung ist ein maschinelles Lernverfahren, bei dem Texte automatisch in vordefinierte Kategorien eingeteilt werden. Häufig angewendete Methoden sind das Bag-of-Words-Modell, das TF-IDF-Verfahren und Machine-Learning-Algorithmen wie Naive Bayes oder Support Vector Machines. Diese Methoden analysieren den Text auf Basis von Merkmalen wie Wortfrequenzen oder semantischen Zusammenhängen, um eine präzise Klassifizierung zu ermöglichen. **
Was sind die gängigsten Methoden zur Kategorisierung von Texten in der Textklassifizierung?
Die gängigsten Methoden zur Kategorisierung von Texten in der Textklassifizierung sind die Verwendung von Machine Learning-Algorithmen wie Naive Bayes, Support Vector Machines und künstlichen neuronalen Netzen. Zudem werden häufig statistische Ansätze wie TF-IDF und Bag-of-Words verwendet, um Texte zu analysieren und zu kategorisieren. Auch die Verwendung von NLP-Techniken wie Named Entity Recognition und Sentiment Analysis kann bei der Kategorisierung von Texten hilfreich sein. **

Ähnliche Suchbegriffe für Textklassifizierung
Top-Angebote
Produkte zum Begriff Textklassifizierung:
-
Haake, Birgit: Revenue Management im MICERevenue Management im MICE , Erträge im Hotel und Eventmanagement optimieren , Sonstige > Anschluss & Kupplung , Erscheinungsjahr: 20210830, Produktform: Kartoniert, Autoren: Haake, Birgit~Zech, Nicola, Seitenzahl/Blattzahl: 139, Keyword: Attendee Density; Buchung; Conference; Corona; Covid-19; Demand-Forecast; Ertragsmanagement; Event; F&B-Outlets; Financial Forecast; Forecast; GOPPAR; Green Meeting; Group Convention Sales Manager; Hotel; Kennzahlen; Key Performance Indicator; Konferenzen; Kongresse; MICE; Online-Buchungsportale; Operational Forecast; Pending; Point-of-Sales-Systeme; Preisdifferenzierung; Preisgestaltung; Preisstrategie; ProPAST; ProPOST; Profit Center; Property Management System; RFP; Rentabilität; RevPAR; RevPASM; RevPAST; RevPOST; Revenue Management; Sales&Catering System; Space Utilization; Stornobedingungen; TRevPAR; Tagungspaket; Total Revenue Management; Trendanalysen; Venue Occupany, Fachschema: Gastgewerbe, Fachkategorie: Reise: Sachbuch, Ratgeber, Thema: Orientieren, Warengruppe: HC/Wirtschaft/Einzelne Wirtschaftszweige, Fachkategorie: Gastgewerbe, Sport-, Freizeit- und Tourismusindustrie, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Uvk Verlag, Verlag: Uvk Verlag, Verlag: UVK, Länge: 211, Breite: 145, Höhe: 11, Gewicht: 220, Produktform: Kartoniert, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, eBook EAN: 9783739800998 9783739880440, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0002, Tendenz: 0, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel,29,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter


-
Wie kann Textklassifizierung dabei helfen, große Textmengen automatisch zu kategorisieren und analysieren?
Textklassifizierung kann dabei helfen, große Textmengen automatisch in vordefinierte Kategorien einzuteilen, um eine effiziente Analyse zu ermöglichen. Durch die automatische Kategorisierung können relevante Informationen schneller identifiziert und extrahiert werden. Dies ermöglicht eine schnellere Verarbeitung und Auswertung großer Textmengen. **
-
Was sind die gängigsten Techniken zur Textklassifizierung und welche Anwendungen können davon profitieren?
Die gängigsten Techniken zur Textklassifizierung sind Bag-of-Words, TF-IDF und Word Embeddings. Anwendungen wie Spam-Erkennung, Sentiment-Analyse und Themenmodellierung können von diesen Techniken profitieren. Durch die automatische Klassifizierung von Texten können Unternehmen effizienter arbeiten und bessere Entscheidungen treffen. **
-
Wie kann Textklassifizierung dabei helfen, große Mengen von Texten effizient zu analysieren und zu kategorisieren?
Textklassifizierung kann dabei helfen, große Mengen von Texten automatisch zu analysieren und in vordefinierte Kategorien einzuordnen. Dies spart Zeit und Ressourcen, da menschliche Eingriffe reduziert werden. Zudem ermöglicht es eine schnellere und präzisere Verarbeitung von Informationen. **
-
Wie kann Textklassifizierung dazu beitragen, große Mengen von Daten effizient zu organisieren und zu analysieren?
Textklassifizierung kann dabei helfen, Daten automatisch in verschiedene Kategorien einzuteilen, was die Organisation und Strukturierung erleichtert. Durch die automatische Zuordnung von Texten zu bestimmten Kategorien können relevante Informationen schneller gefunden und analysiert werden. Dies ermöglicht eine effiziente Verarbeitung großer Datenmengen und unterstützt somit die Entscheidungsfindung. **

Wie können maschinelle Lernalgorithmen zur Textklassifizierung effizient trainiert und eingesetzt werden, um semantische Kategorien zu erkennen?
Maschinelle Lernalgorithmen können effizient trainiert werden, indem sie mit einer großen Menge von annotierten Textdaten trainiert werden. Durch die Verwendung von Algorithmen wie dem Naive Bayes oder dem Support Vector Machine können semantische Kategorien erkannt werden. Um die Effizienz zu steigern, können auch Techniken wie Feature-Engineering und Hyperparameter-Optimierung eingesetzt werden. **
Was sind die gängigsten Methoden zur Textklassifizierung und wie können sie in der Praxis angewendet werden?
Die gängigsten Methoden zur Textklassifizierung sind Naive Bayes, Support Vector Machines und Neuronale Netze. Sie können in der Praxis verwendet werden, indem man Textdaten in Trainings- und Testdaten aufteilt, ein Modell mit den Trainingsdaten trainiert und dann die Genauigkeit des Modells mit den Testdaten überprüft. Die Methode mit der höchsten Genauigkeit wird dann für die Textklassifizierung verwendet. **
Top-Angebote
Produkte zum Begriff Textklassifizierung:
-
Neuartige Technik zur Textklassifizierung, Taschenbuch von Abhishek Bhardwaj,Amarpreet Singh,Virat Rehani, Verlag Unser Wissen, 978-620-6-18723-3Neuartige Technik Zur Textklassifizierung, Taschenbuch Von Abhishek Bhardwaj,amarpreet Singh,virat Rehani, Verlag Unser Wissen, 978-620-6-18723-3, Seitenanzahl: 6843,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
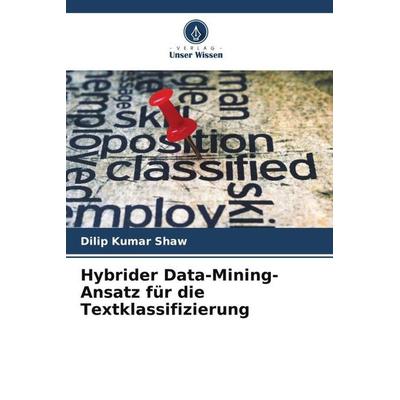
Hybrider Data-Mining-Ansatz für die Textklassifizierung, Taschenbuch von Dilip Kumar Shaw, Verlag Unser Wissen, 978-620-5-46330-7Hybrider Data-mining-ansatz Für Die Textklassifizierung, Taschenbuch Von Dilip Kumar Shaw, Verlag Unser Wissen, 978-620-5-46330-7, Seitenanzahl: 6835,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Haake, Birgit: Revenue Management im MICERevenue Management im MICE , Erträge im Hotel und Eventmanagement optimieren , Sonstige > Anschluss & Kupplung , Erscheinungsjahr: 20210830, Produktform: Kartoniert, Autoren: Haake, Birgit~Zech, Nicola, Seitenzahl/Blattzahl: 139, Keyword: Attendee Density; Buchung; Conference; Corona; Covid-19; Demand-Forecast; Ertragsmanagement; Event; F&B-Outlets; Financial Forecast; Forecast; GOPPAR; Green Meeting; Group Convention Sales Manager; Hotel; Kennzahlen; Key Performance Indicator; Konferenzen; Kongresse; MICE; Online-Buchungsportale; Operational Forecast; Pending; Point-of-Sales-Systeme; Preisdifferenzierung; Preisgestaltung; Preisstrategie; ProPAST; ProPOST; Profit Center; Property Management System; RFP; Rentabilität; RevPAR; RevPASM; RevPAST; RevPOST; Revenue Management; Sales&Catering System; Space Utilization; Stornobedingungen; TRevPAR; Tagungspaket; Total Revenue Management; Trendanalysen; Venue Occupany, Fachschema: Gastgewerbe, Fachkategorie: Reise: Sachbuch, Ratgeber, Thema: Orientieren, Warengruppe: HC/Wirtschaft/Einzelne Wirtschaftszweige, Fachkategorie: Gastgewerbe, Sport-, Freizeit- und Tourismusindustrie, Thema: Verstehen, Text Sprache: ger, UNSPSC: 49019900, Warenverzeichnis für die Außenhandelsstatistik: 49019900, Verlag: Uvk Verlag, Verlag: Uvk Verlag, Verlag: UVK, Länge: 211, Breite: 145, Höhe: 11, Gewicht: 220, Produktform: Kartoniert, Genre: Sozialwissenschaften/Recht/Wirtschaft, Genre: Sozialwissenschaften/Recht/Wirtschaft, eBook EAN: 9783739800998 9783739880440, Herkunftsland: DEUTSCHLAND (DE), Katalog: deutschsprachige Titel, Katalog: Gesamtkatalog, Katalog: Lagerartikel, Book on Demand, ausgew. Medienartikel, Relevanz: 0002, Tendenz: 0, Unterkatalog: AK, Unterkatalog: Bücher, Unterkatalog: Hardcover, Unterkatalog: Lagerartikel,29,90 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie funktioniert die Textklassifizierung und welche Methoden werden dabei häufig angewendet?
Die Textklassifizierung ist ein maschinelles Lernverfahren, bei dem Texte automatisch in vordefinierte Kategorien eingeteilt werden. Häufig angewendete Methoden sind das Bag-of-Words-Modell, das TF-IDF-Verfahren und Machine-Learning-Algorithmen wie Naive Bayes oder Support Vector Machines. Diese Methoden analysieren den Text auf Basis von Merkmalen wie Wortfrequenzen oder semantischen Zusammenhängen, um eine präzise Klassifizierung zu ermöglichen. **
-
Was sind die gängigsten Methoden zur Kategorisierung von Texten in der Textklassifizierung?
Die gängigsten Methoden zur Kategorisierung von Texten in der Textklassifizierung sind die Verwendung von Machine Learning-Algorithmen wie Naive Bayes, Support Vector Machines und künstlichen neuronalen Netzen. Zudem werden häufig statistische Ansätze wie TF-IDF und Bag-of-Words verwendet, um Texte zu analysieren und zu kategorisieren. Auch die Verwendung von NLP-Techniken wie Named Entity Recognition und Sentiment Analysis kann bei der Kategorisierung von Texten hilfreich sein. **
-
Wie kann Textklassifizierung dabei helfen, große Textmengen automatisch zu kategorisieren und analysieren?
Textklassifizierung kann dabei helfen, große Textmengen automatisch in vordefinierte Kategorien einzuteilen, um eine effiziente Analyse zu ermöglichen. Durch die automatische Kategorisierung können relevante Informationen schneller identifiziert und extrahiert werden. Dies ermöglicht eine schnellere Verarbeitung und Auswertung großer Textmengen. **
-
Was sind die gängigsten Techniken zur Textklassifizierung und welche Anwendungen können davon profitieren?
Die gängigsten Techniken zur Textklassifizierung sind Bag-of-Words, TF-IDF und Word Embeddings. Anwendungen wie Spam-Erkennung, Sentiment-Analyse und Themenmodellierung können von diesen Techniken profitieren. Durch die automatische Klassifizierung von Texten können Unternehmen effizienter arbeiten und bessere Entscheidungen treffen. **
Ähnliche Suchbegriffe für Textklassifizierung
-
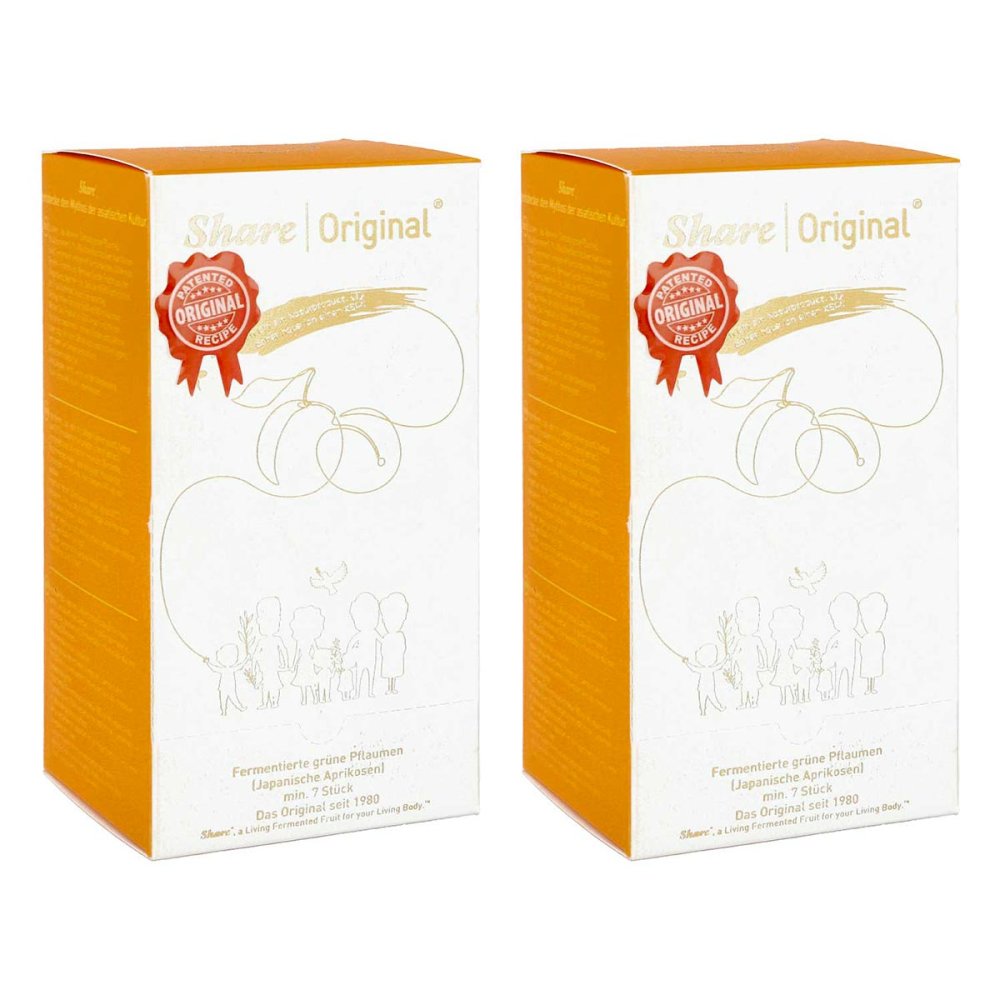
SHARE GERMANY GmbH Share Original Fermentierte Grüne Pflaumen 08105886Anwendungsgebiet von Share Original Fermentierte Grüne Pflaumen ShareOriginal®-Pflaume – mehr als nur eine Frucht Die Share Original Fermentierte Grüne Pflaumen ist kein gewöhnliches Trockenobst – ganze 30 Monate wird jede Frucht im eigenen Saft fermentiert, bevor sie ummantelt mit wertvollen Kräutern und Früchten in den Handel kommt.Per Hand sorgfältig ausgewählt und frei von Gentechnik und Zusatzstoffen, steht diese Pflaume für natürliche Reinheit. Laut traditionell-chinesischer Medizin kann sie sogar das Qi – die körpereigene Lebensenergie – stärken.Wirkstoffe / Inhaltsstoffe / ZutatenShare Original Fermentierte Grüne Pflaumen enthält:Zutaten: Fermentierte grüne Pflaumen (japanische Aprikose) Prunus Mume, Kräutermantel 0,1%.Nährwertangabepro 100 gBrennwert / Energie1197 kJ / 282 kcalFett GegenanzeigenBei bekannter Überempfindlichkeit gegenüber einem der oben genannten Inhaltsstoffe sollte das Produkt nicht verwendet werden.DosierungVerzehrempfehlung von Share Original Fermentierte Grüne Pflaumen:Wir empfehlen Ihnen, täglich eine halbe bis ganze ShareOriginal®-Pflaume zu genießen – idealerweise über einen Zeitraum von mindestens drei Monaten. So kann die Frucht ihr volles Potenzial entfalten und Ihren Körper optimal unterstützen.Entnehmen Sie die Frucht vorsichtig aus der Verpackung – bitte beachten Sie, dass sich der Kern noch im Inneren befindet. Kauen Sie die Frucht langsam und achtsam.Wichtig: Trinken Sie im Anschluss 500 ml warmes Wasser, um die Wirkung optimal zu unterstützen. Share Original Fermentierte Grüne Pflaumen können in Ihrer Versandapotheke apodiscounter erworben werden.49,89 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Wie kann Textklassifizierung dabei helfen, große Mengen von Texten effizient zu analysieren und zu kategorisieren?
Textklassifizierung kann dabei helfen, große Mengen von Texten automatisch zu analysieren und in vordefinierte Kategorien einzuordnen. Dies spart Zeit und Ressourcen, da menschliche Eingriffe reduziert werden. Zudem ermöglicht es eine schnellere und präzisere Verarbeitung von Informationen. **
-
Wie kann Textklassifizierung dazu beitragen, große Mengen von Daten effizient zu organisieren und zu analysieren?
Textklassifizierung kann dabei helfen, Daten automatisch in verschiedene Kategorien einzuteilen, was die Organisation und Strukturierung erleichtert. Durch die automatische Zuordnung von Texten zu bestimmten Kategorien können relevante Informationen schneller gefunden und analysiert werden. Dies ermöglicht eine effiziente Verarbeitung großer Datenmengen und unterstützt somit die Entscheidungsfindung. **
-
Wie können maschinelle Lernalgorithmen zur Textklassifizierung effizient trainiert und eingesetzt werden, um semantische Kategorien zu erkennen?
Maschinelle Lernalgorithmen können effizient trainiert werden, indem sie mit einer großen Menge von annotierten Textdaten trainiert werden. Durch die Verwendung von Algorithmen wie dem Naive Bayes oder dem Support Vector Machine können semantische Kategorien erkannt werden. Um die Effizienz zu steigern, können auch Techniken wie Feature-Engineering und Hyperparameter-Optimierung eingesetzt werden. **
-
Was sind die gängigsten Methoden zur Textklassifizierung und wie können sie in der Praxis angewendet werden?
Die gängigsten Methoden zur Textklassifizierung sind Naive Bayes, Support Vector Machines und Neuronale Netze. Sie können in der Praxis verwendet werden, indem man Textdaten in Trainings- und Testdaten aufteilt, ein Modell mit den Trainingsdaten trainiert und dann die Genauigkeit des Modells mit den Testdaten überprüft. Die Methode mit der höchsten Genauigkeit wird dann für die Textklassifizierung verwendet. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.